Mesurer la diversité des panels à partir d’indices de défavorisation sociale et d’un indice entropie
Par Khadija Hafsia, Data Data les données numériques En savoir plus analyst, Diane Maillot-Tchofo, Data analyst, et Aurélie Vanheuverzwyn, Directrice exécutive Data & Méthodes - Médiamétrie
14e Colloque Francophone sur les Sondages, 19-22 mai 2026, Vannes
La diversité sociale est un concept multi-dimensionnel, englobant des questions telles que le milieu économique, culturel ou religieux. Or, le traitement de données sensibles données sensibles Les données sensibles forment une catégorie particulière des données personnelles. Ce sont des informations qui révèlent la prétendue origine raciale ou ethnique, les opinions politiques, les convictions religieuses ou philosophiques ou l'appartenance syndicale, ainsi que le traitement des données génétiques, des données biométriques aux fins d'identifier une personne physique de manière unique, des données concernant la santé ou des données concernant la vie sexuelle ou l'orientation sexuelle d'une personne physique. Le règlement européen interdit de recueillir ou d’utiliser ces données, sauf, notamment, dans les cas suivants : si la personne concernée a donné son consentement exprès (démarche active, explicite et de préférence écrite, qui doit être libre, spécifique, et informée) ; si les informations sont manifestement rendues publiques par la personne concernée ; si elles sont nécessaires à la sauvegarde de la vie humaine ; si leur utilisation est justifiée par l'intérêt public et autorisé par la CNIL ; si elles concernent les membres ou adhérents d'une association ou d'une organisation politique, religieuse, philosophique, politique ou syndicale. En savoir plus telles que l’origine raciale ou ethnique, les opinions politiques ou les convictions religieuses n’est autorisé par la CNIL que dans des cas spécifiques comme l’intérêt public ou la sauvegarde de la vie humaine.

Médiamétrie, en tant qu’institut de
sondage
sondage
Méthode statistique qui vise à produire des informations sur une population en n’interrogeant qu’une partie de celle-ci (échantillon). Ce mot est généralement utilisé pour désigner une enquête menée auprès d'un échantillon, interrogé par questionnaire ou observé de façon systématique.
En savoir plus
privé spécialisé dans la mesure d’audience ne remplit pas les conditions requises. Néanmoins, la
question
question
Interrogation posée à l'identique à toutes les personnes participant à une même enquête, dans le but d'obtenir des réponses de même nature. On distingue les questions fermées, dont les réponses sont à choisir parmi les modalités proposées (échelles, oui ou non, modalités d'une nomenclature, etc...), des questions ouvertes, pour lesquelles aucune modalité de réponse n'est proposée. Dans ce dernier cas, c'est la réponse spontanée des personnes interrogées qui est recueillie.
En savoir plus
de la représentativité des panels de mesure d’audience, au-delà des critères socio-démographiques classiques, est au coeur des préoccupations de ses clients. A titre d’exemple, dans son projet de Contrat d’Objectifs et Moyens (COM) 2024-2028, France Télévisions a pris des engagements en matière de diversité et d’inclusion dans ses programmes.
Pour aborder la question, deux approches peuvent être adoptées : l’ajout de questions dans les questionnaires de recrutement des panélistes ou le recours à un
proxy
proxy
Serveur mandataire qui crée un écran entre l'internaute et les serveurs Web. Il peut être transparent chez les fournisseurs d'accès Internet pour pouvoir enregistrer et analyser le trafic des abonnés des opérateurs (par exemple à des fins de filtrage ou d'investigations judiciaires).
En savoir plus
déterminé à partir de données officielles. La première option présente un certain nombre de contraintes opérationnelles. Les informations sur le revenu des ménages, par exemple, sont souvent non déclarées dans leur exhaustivité ou affectées d’erreurs de mesure (e.g. brut vs net, avant vs après imposition, revenu individuel vs revenu du
ménage
ménage
Un ménage, au sens statistique du terme, désigne l'ensemble des occupants d'un même logement sans que ces personnes soient nécessairement unies par des liens de parenté. Un ménage peut être composé d'une seule personne. La population des ménages exclut donc de fait les communautés (foyers de travailleurs, maisons de retraite, résidences universitaires, maisons de détention,...), les sans abris, les mariniers et les personnes vivant dans des habitations mobiles.
En savoir plus
, etc.). La deuxième option repose sur les données de
Statistique
Statistique
La statistique ou science des données (Data Science en anglais) est un domaine des mathématiques qui étudie des phénomènes à travers la collecte de données, leur traitement, leur analyse, leur représentation graphique ou visualisation (Data Visualization en anglais) et l'interprétation des résultats.
En savoir plus
Publique, pour lesquelles nous disposons de références fiables auxquelles comparer les structures de nos enquêtes par
panel
panel
Échantillon pour lequel le recueil de l'information s'inscrit dans le temps. Il peut être interrogé plusieurs fois à intervalles réguliers. Cette méthode est pertinente pour l'étude des évolutions de comportement.
L'échantillon peut être interrogé en continu :
- soit, il est demandé à chaque individu du panel de remplir un questionnaire journalier relatif au sujet de l'étude. C'est le cas du panel Radio.
- soit, l'information est enregistrée et restituée régulièrement. C'est le cas du panel Médiamat. Cette méthode est pertinente pour saisir les habitudes de comportement et leur évolution si la durée du panel est suffisamment longue.
En savoir plus
.
En optant pour la deuxième approche, nous avons sélectionné quatre indicateurs : deux indices de défavorisation (un français et un européen), ainsi qu’un indice de pauvreté et un indice de richesse. Ces indices sont calculés au niveau de l’IRIS. Notre approche consiste à associer à chaque membre du panel la valeur de l’indice de son IRIS. Par ailleurs, nous avons identifié l’indice d’entropie qui mesure la diversité notamment à partir de caractéristiques disponibles directement dans nos données.
1. Contexte et données
Pour mesurer l’audience de la télévision, Médiametrie a recours à ses panels
Médiamat
Médiamat
« Nom déposé, le Médiamat est la mesure automatique de référence de l’audience de la télévision en France. Réalisée par Médiamétrie, elle restitue quotidiennement l’audience des programmes regardés en tous lieux, sur tous les écrans et visionnés en live, différé, replay ou preview par l’ensemble des Français âgés de 4 ans et plus, soit 62,4 millions d’individus.
Cette mesure repose sur 2 panels représentatifs de la population :
- Un premier panel d’environ 12 000 individus répartis dans 5 500 foyers composé de :
• 5 000 foyers équipés de téléviseurs à domicile reliés chacun à un audimètre fixe, source de la mesure de l’audience TV à domicile
• 500 foyers sans téléviseur à domicile
- Un second panel d'environ 5 000 individus portant un audimètre miniature pour mesurer notamment les audiences TV hors domicile (tous écrans confondus) et sur les écrans internet à domicile. Ces audiences sont ensuite attribuées aux individus du premier panel par fusion statistique.
Le Médiamat permet un suivi quotidien des comportements du public, tout en offrant des possibilités d'analyses à la fois éditoriales et publicitaires. »
En savoir plus
et
AIP (Audimètre Individuel Porté)
AIP (Audimètre Individuel Porté)
Un audimètre individuel porté se présente sous la forme d'un petit boitier porté par un panéliste à sa taille, en pendentif ou au poignet. Ce boitier analyse le son ambiant pour détecter l'exposition du panéliste à un média TV ou Radio. Il transmet périodiquement ses mesures aux serveurs de la société de mesure d'audience, soit de façon autonome via un réseau cellulaire, soit en se connectant par une liaison Bluetooth à une station installée au domicile du panéliste.
En savoir plus
. Le
panel
panel
Échantillon pour lequel le recueil de l'information s'inscrit dans le temps. Il peut être interrogé plusieurs fois à intervalles réguliers. Cette méthode est pertinente pour l'étude des évolutions de comportement.
L'échantillon peut être interrogé en continu :
- soit, il est demandé à chaque individu du panel de remplir un questionnaire journalier relatif au sujet de l'étude. C'est le cas du panel Radio.
- soit, l'information est enregistrée et restituée régulièrement. C'est le cas du panel Médiamat. Cette méthode est pertinente pour saisir les habitudes de comportement et leur évolution si la durée du panel est suffisamment longue.
En savoir plus
Médiamat est un panel constitué d’environ 5600 ménages vivant en France métropolitaine, qu’ils soient ou non équipés d’une télévision. Les foyers équipés d’une télévision ont un
audimètre
audimètre
Appareil permettant de mesurer l'audience des programmes de radio ou de télévision. Les audimètres prennent en compte automatiquement toute opération d'allumage et d'extinction des postes, de changement de chaîne, de lecture de contenus enregistrés sur le décodeur ou de services de replay/preview. Ils permettent aussi une mesure de l'audience individuelle grâce à une télécommande à bouton-poussoir, chaque membre du foyer disposant de sa propre touche pour déclarer sa présence dans la pièce. L'audimètre est relié par le réseau téléphonique à un ordinateur qui collecte et traite les données recueillies.
En savoir plus
fixe branché à leurs télévisions. L’ensemble des individus âgés de 4 ans et plus des ménages du panel participent à la mesure de la télévision.
Le panel AIP est un panel constitué d’environ 6000 individus âgés de 13 ans et plus. Les panélistes sont munis d’un audimètre qu’ils portent à domicile et en dehors. Pour les deux panels, chaque
foyer
foyer
Un foyer ou ménage, au sens statistique du terme, désigne l'ensemble des occupants d'un même logement sans que ces personnes soient nécessairement unies par des liens de parenté. Un ménage peut être composé d'une seule personne. La population des ménages exclut donc de fait les communautés (foyers de travailleurs, maisons de retraite, résidences universitaires, maisons de détention,...), les sans abris, les mariniers et les personnes vivant dans des habitations mobiles.
En savoir plus
(pour le panel Médiamat) ou chaque
panéliste
panéliste
Individu faisant partie d'un panel.
En savoir plus
(pour le panel AIP) est qualifié de données foyer, telles que le nombre de personnes dans le foyer (npf), la catégorie socio-professionnelle (csp) de la
personne de référence
personne de référence
La personne de référence d'un ménage est définie par l'Insee selon une règle basée sur la prédominance donnée aux couples, à l'activité et à l'âge. La personne de référence d’un ménage est :
- la personne active la plus âgée ayant un conjoint ;
- à défaut de personne active ayant un conjoint, la personne la plus âgée ayant un conjoint ;
- à défaut de personne ayant un conjoint, la personne active la plus âgée ;
- à défaut de personne active, la personne la plus âgée.
En savoir plus
du foyer (pdr), leur département de résidence, leur équipement d’une télévision,etc ainsi que des
données individuelles
données individuelles
Ensemble des informations recueillies ou recalculées pour un même individu de l'échantillon.
En savoir plus
telles l’âge des individus, leur
CSP
CSP
La CSP (catégorie socioprofessionnelle), remplacée en 1982 par la nomenclature des professions et catégories socioprofessionnelles (PCS), est une nomenclature définie par l'Insee qui permet de classer la population selon une synthèse de la profession (ou de l'ancienne profession), de la position hiérarchique et du statut (salarié ou non).
En savoir plus
, leur équipement de téléphone mobile.
Nous disposons de données socio-démographiques, d’équipement, d’abonnement et d’usages multimédias. Les différentes granularités de données nous permettent d’exploiter les panels au niveau foyer et individu.
Afin d’assurer une mesure juste et pertinente de l’audience télévisuelle, il faut s’assurer de la bonne représentativité de nos panels selon les différents critères évoqués ci-dessus, notamment la diversité sociale de nos panélistes. La diversité sociale est un concept multi-dimensionnel, englobant des questions telles que le milieu économique, culturel ou religieux. Or, le traitement de
données sensibles
données sensibles
Les données sensibles forment une catégorie particulière des données personnelles.
Ce sont des informations qui révèlent la prétendue origine raciale ou ethnique, les opinions politiques, les convictions religieuses ou philosophiques ou l'appartenance syndicale, ainsi que le traitement des données génétiques, des données biométriques aux fins d'identifier une personne physique de manière unique, des données concernant la santé ou des données concernant la vie sexuelle ou l'orientation sexuelle d'une personne physique.
Le règlement européen interdit de recueillir ou d’utiliser ces données, sauf, notamment, dans les cas suivants :
si la personne concernée a donné son consentement exprès (démarche active, explicite et de préférence écrite, qui doit être libre, spécifique, et informée) ;
si les informations sont manifestement rendues publiques par la personne concernée ;
si elles sont nécessaires à la sauvegarde de la vie humaine ;
si leur utilisation est justifiée par l'intérêt public et autorisé par la CNIL ;
si elles concernent les membres ou adhérents d'une association ou d'une organisation politique, religieuse, philosophique, politique ou syndicale.
En savoir plus
telles que l’origine raciale ou ethnique, les opinions politiques ou les convictions religieuses n’est autorisé par la CNIL que dans des cas spécifiques comme l’intérêt public ou la sauvegarde de la vie humaine, etc.
Médiamétrie, en tant qu’institut de
sondage
sondage
Méthode statistique qui vise à produire des informations sur une population en n’interrogeant qu’une partie de celle-ci (échantillon). Ce mot est généralement utilisé pour désigner une enquête menée auprès d'un échantillon, interrogé par questionnaire ou observé de façon systématique.
En savoir plus
privé spécialisé dans la mesure d’audience n’a pas accès à certaines données telles que des indicateurs de pauvreté à des granularités fines1, et n’est pas autorisé à poser certaines questions à ses panélistes et en archiver les réponses. En prenant en compte ces différentes contraintes, nous nous assurons de la représentative de nos panels en ayant recours à des indicateurs développés par des chercheurs en sciences sociales (e.g.démographes) pour des visées de recherche académiques ou de politiques publiques.
1 Retrouver les indices de pauvreté non-disponibles à la publication dans les petits IRIS, avec moins de x nombre d’habitants
2. Des indices pour qualifier le panel panel Échantillon pour lequel le recueil de l'information s'inscrit dans le temps. Il peut être interrogé plusieurs fois à intervalles réguliers. Cette méthode est pertinente pour l'étude des évolutions de comportement. L'échantillon peut être interrogé en continu : - soit, il est demandé à chaque individu du panel de remplir un questionnaire journalier relatif au sujet de l'étude. C'est le cas du panel Radio. - soit, l'information est enregistrée et restituée régulièrement. C'est le cas du panel Médiamat. Cette méthode est pertinente pour saisir les habitudes de comportement et leur évolution si la durée du panel est suffisamment longue. En savoir plus
Nous avons cherché dans la littérature scientifique des indices synthétiques de diversité et avons sélectionné 4 indicateurs qui cherchent à qualifier le territoire français sur le spectre socio-économique. Il s’agit d’indices de défavorisation sociale, de pauvreté et de richesse. Ces indicateurs développent des définitions complémentaires de la défavorisation et de la pauvreté, avec des indicateurs de pauvreté matérielles et de revenus d’un côté (cf. F-DEP et les indices de pauvreté et de richesse), et des indices combinant des variables de pauvreté objectives (revenus) et subjectives (situation financière perçue) (cf. EDI). Les indicateurs évoqués ci-dessus sont calculés au niveau de l’IRIS. L’IRIS («Ilots Regroupés pour l’Information Statistique Statistique La statistique ou science des données (Data Science en anglais) est un domaine des mathématiques qui étudie des phénomènes à travers la collecte de données, leur traitement, leur analyse, leur représentation graphique ou visualisation (Data Visualization en anglais) et l'interprétation des résultats. En savoir plus ») est un découpage géographique de l’espace, mis en place par l’INSEE pour la diffusion diffusion Passage d'une émission ou d'un programme à la télévision ou à la radio. Ce terme fait référence à un programme "live" par opposition à la consultation à la demande. En savoir plus de données infra-communales. Les communes d’au moins 10 000 habitants et une forte proportion des communes de 5 000 à 10 000 habitants sont découpées en IRIS. Ce découpage constitue une partition de leur territoire. La France compte environ 16 000 IRIS dont 750 dans les DOM. Par extension, afin de couvrir l’ensemble du territoire, on assimile à un IRIS chacune des communes de France non découpées en IRIS, ce qui conduit à un découpage géographique du territoire en 49 500 unités urbaines.
2.1 Deux indices à analyser
2.1.1 F-DEP
L’indice de défavorisation sociale appelé FDep a été développé dans le contexte français [6]. Il a été construit à l’échelle communale à partir des données de recensement recensement Technique de recueil d'informations s'appliquant à la totalité d'une population, par opposition au sondage, qui ne s'applique par définition qu'à un échantillon. Le plus souvent, un recensement consiste en un dénombrement exhaustif, au cours duquel sont, de plus, posées quelques questions de nature socio-démographique. Exemple : le recensement national de la population par l'INSEE qui donne lieu à une publication de résultats tous les ans. En savoir plus de la population population Univers d'une enquête composé des unités statistiques de base. Ces unités peuvent être des personnes physiques, des foyers, des entreprises, des communes... La population sert de base de sondage pour le choix de l'échantillon, et de base de calcul pour les extrapolations de l'échantillon. En savoir plus de 1999 (Insee) et des revenus fiscaux des ménages de 2001 (Insee-DGI). Le même indice a été calculé à partir des données de 1990. Quatre variables, représentant toutes une dimension fondamentale du niveau socioéconomique, de signification homogène dans l’ensemble du pays et covariant de façon similaire selon la tranche d’unités urbaines ont été utilisées : le pourcentage d’ouvriers dans la population active, le pourcentage de bacheliers chez les 15 ans et plus, le pourcentage de chômeurs dans la population active et le revenu médian par foyer foyer Un foyer ou ménage, au sens statistique du terme, désigne l'ensemble des occupants d'un même logement sans que ces personnes soient nécessairement unies par des liens de parenté. Un ménage peut être composé d'une seule personne. La population des ménages exclut donc de fait les communautés (foyers de travailleurs, maisons de retraite, résidences universitaires, maisons de détention,...), les sans abris, les mariniers et les personnes vivant dans des habitations mobiles. En savoir plus . L’indice a été obtenu à l’aide d’une analyse en composantes principales (ACP) conduite sur ces quatre variables. Les résultats de l’ACP étaient similaires lorsque l’analyse était conduite au niveau national ou dans chaque tranche d’unité urbaine. L’association entre défavorisation sociale et mortalité sur la période 1997-2001 est observée quelle que soit l’échelle spatiale choisie (commune, canton, zone d’emploi, département et région région Découpage géographique. La France métropolitaine est organisée administrativement en 13 régions (régions INSEE - anciennement 22). En savoir plus ), le FDep calculé pour les échelles autres que communale étant obtenu comme la moyenne moyenne La moyenne est un des premiers indicateurs statistiques pour une série de nombres. Par défaut, il s’agit de la moyenne arithmétique, qui se calcule comme la somme des valeurs de la série, divisée par le nombre de valeurs. En savoir plus pondérée sur la population des valeurs obtenues au niveau communal. De même, l’association entre défavorisation sociale et mortalité se retrouve dans toutes les tranches d’unité urbaines. Cet indice est actuellement utilisé par la CNAM-TS. L’indice est découpé selon les quintiles de sa distribution: le 1er quintile correspond aux IRIS les plus favorisés et le dernier quintile aux IRIS les plus défavorisés. Le F-Dep le plus récent dont on dispose a été calculé sur les données de 2019.
2.1.2 European Deprivation Index
Un indice de défavorisation sociale à visée européenne, l’EDI ou "european deprivation index", a été proposé[5]. La méthodologie est différente de celle utilisée pour les indices de défavorisation sociale habituellement rencontrés. Elle prend comme point de départ la définition de la défavorisation de Towsend, et postule qu’il n’y a pas de gold standard pour la mesurer en ce qui concerne le choix des variables, celles-ci variant selon les pays. La démarche consiste donc à définir cette notion dans la population étudiée, avec les variables pertinentes, avant de construire l’indice. Elle repose sur la sélection d’une combinaison de variables qui sont disponibles à la fois au niveau individuel dans une
enquête
enquête
Dispositif de recueil d'informations. On distingue les enquêtes téléphoniques, postales, en face-à-face, en ligne. Bien qu'ayant un sens plus large, le terme d'étude est souvent utilisé comme synonyme.
En savoir plus
européenne dédiée à l’étude de la défavorisation et au niveau géographique dans le recensement de la population et qui reflète au mieux l’expérience individuelle de défavorisation sociale. L’enquête européenne utilisée est l’étude EU-SILC (European Union – Statistics on Income and Living Conditions) ou SRCV dans sa version française (Statistiques sur Revenus et Conditions de vie), qui vise à collecter des données sur le revenu, la pauvreté, l’exclusion sociale et les conditions de vie. Cette étude annuelle inclut 26 pays depuis 2005. Une
régression
régression
Problème d’apprentissage automatique supervisé, la régression se concentre sur la façon dont une valeur cible change lorsque d’autres valeurs d’un jeu de données changent.
Les problèmes de régression concernent généralement des variables continues, telles que, par exemple, la manière dont la superficie et l’emplacement affectent le prix d’une maison.
En savoir plus
logistique sur les données de l’enquête européenne permet de ne conserver parmi les variables analysées que celles associés à l’indicateur de défavorisation. Les coefficients de régression associés à chacune de ces variables deviennent les
poids
poids
1. Proportion d'une catégorie d'individus par rapport à la totalité de la population. Par exemple, au 1er janvier 2020, le poids des femmes est de 51,7% de la population des ménages.
2. Le poids de sondage désigne le coefficient affecté à chaque individu de l'échantillon et qui représente l'inverse de sa probabilité d'appartenir à l'échantillon. Par exemple, pour un échantillon de 20 000 individus tirés aléatoirement au sein d'une population de 40 millions d'individus, le poids de sondage est de 2 000.
3. Le poids de redressement désigne le coefficient affecté à chaque individu après redressement de l'échantillon et qui correspond au nombre d'individus que cet individu de l'échantilllon représente dans la population.
En savoir plus
de ces variables
dans l’EDI. Dans sa dernière version basée sur les données de 2017 (données EU-SILC et données de recensement), les variables intervenant dans son calcul sont le pourcentage de :
• ménages sans voiture,
• ménages de plus de 6 personnes,
• ménages composés d’une
famille
famille
Une famille est constituée d'un couple (marié ou non) et, le cas échant, de ses enfants, ou encore d'une personne sans conjoint et de ses enfants (famille monoparentale). Notion à ne pas confondre avec celle de ménage, un ménage pouvant comprendre zéro, une ou plusieurs familles.
En savoir plus
monoparentale,
• ménages surpeuplés (ie ayant plus d’une personne par pièce),
• ménages non propriétaires,
• personnes au chômage,
• personnes de nationalité étrangère,
• personnes dont la profession n’est ni cadre ni profession intermédiaire,
• personnes ayant un diplôme inférieur à l’enseignement supérieur,
• personnes non mariées.
L’indice a ensuite été découpé selon les quintiles de sa distribution: le 1er quintile correspond
aux IRIS les plus favorisés et le dernier quintile aux IRIS les plus défavorisés.
2.1.3 Indices de pauvreté et de richesse
Pour caractériser l’extrémité basse de la distribution des revenus, on utilise généralement le taux de pauvreté (soit la proportion de population appartenant à des ménages dont le revenu est inférieur ou égal à 60% du revenu médian national par unité de consommation). Mais il n’existe pas d’indicateur standard pour définir l’extrémité haute. Dans le cadre d’une étude sur la polarisation socio-économique des quartiers des métropoles françaises de province, des chercheurs de l’Université de Bordeaux ont proposé des indicateurs synthétisant les extrémités de la distribution des revenus basés sur les déciles de revenus disponibles par unité de consommation, informations disponibles par IRIS [3] (Gripsiou et Bergouignan, 2021).
L’indice de richesse proposé est calculé comme la somme pondérée des écarts relatifs positifs entre les 3 derniers déciles (D7z,D8z,D9z) de chaque iris z, avec les déciles correspondants de l’ensemble de la France métropolitaine (D7FM,D8FM,D9FM) :
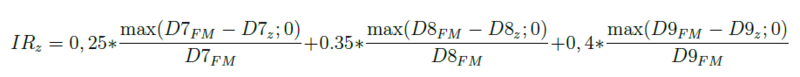
Les coefficients de pondération sont croissants au fil des déciles de façon à pondérer davantage les écarts associés aux revenus les plus élevés.
L’indice de pauvreté est calculé de manière symétrique comme la somme pondérée des écarts relatifs négatifs entre les 3 premiers déciles (D1z,D2z,D3z) de chaque iris z, avec les déciles correspondants de l’ensemble de la France métropolitaine (D1FM,D2FM,D3FM) :
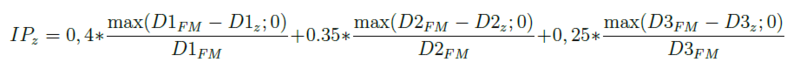
2.2 Applications & résultats
Nous avons qualifié les deux panels, c’est-à-dire en identifiant l’IRIS de chaque panéliste, et y associant l’indice de l’IRIS. Nous avons procédé de la sorte pour les 4 indices évoqués.
F-DEP
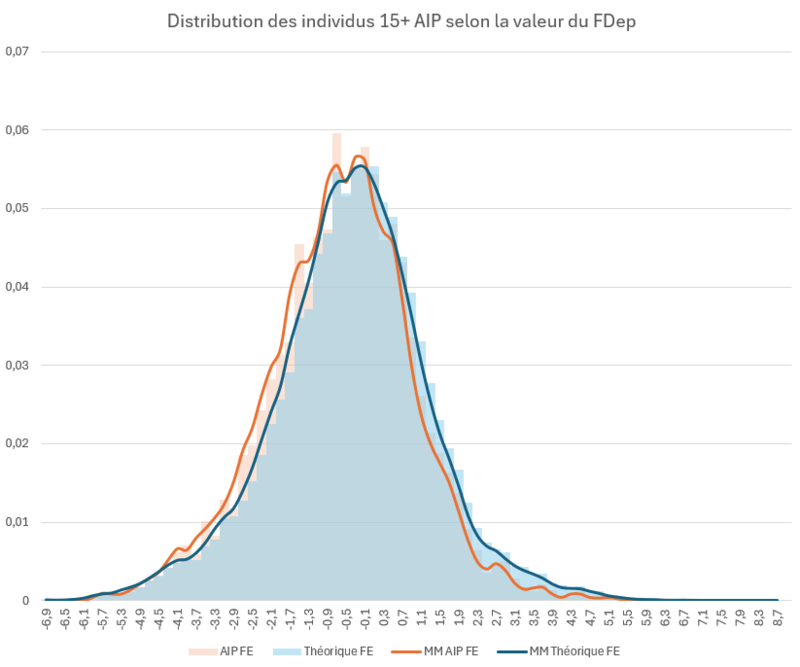
On analyse la distribution des panélistes AIP de 15 ans et plus selon leur valeur de F-DEP en comparaison avec la distribution théorique de la
population
population
Univers d'une enquête composé des unités statistiques de base. Ces unités peuvent être des personnes physiques, des foyers, des entreprises, des communes... La population sert de base de sondage pour le choix de l'échantillon, et de base de calcul pour les extrapolations de l'échantillon.
En savoir plus
. Au global, on observe dans
Fig.1 une distribution de l’indice équivalent à celle du théorique.
EDI
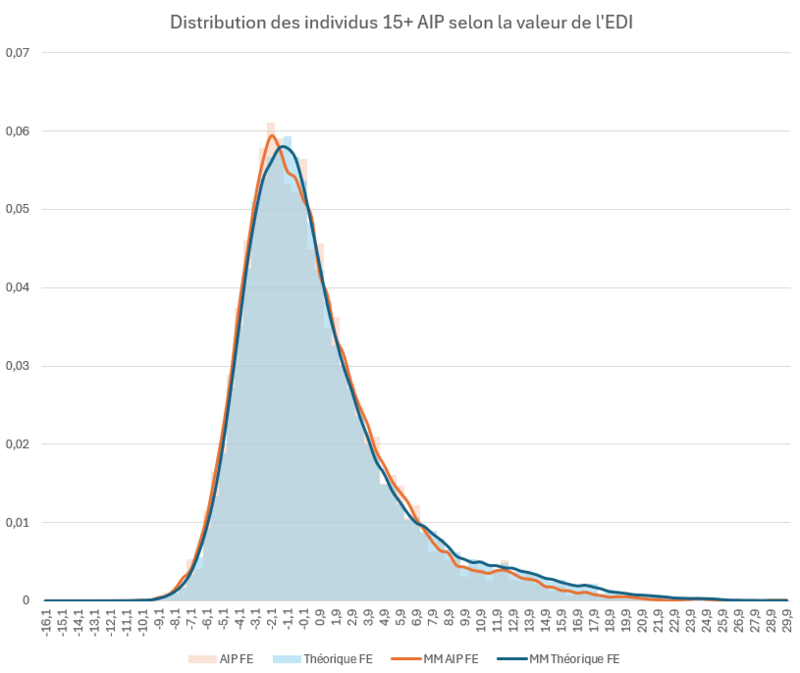
On analyse ici la distribution des panélistes AIP de 15 ans et plus selon leur valeur d’EDI, en comparaison avec la distribution théorique de la
population
population
Univers d'une enquête composé des unités statistiques de base. Ces unités peuvent être des personnes physiques, des foyers, des entreprises, des communes... La population sert de base de sondage pour le choix de l'échantillon, et de base de calcul pour les extrapolations de l'échantillon.
En savoir plus
en France métropolitaine. Selon cet indice, qui prend en compte les aspects matériels de la défavorisation sociale plutôt que les aspects financiers, le constat est le même que pour le F-DEP (Fig.2).
Les indices de pauvreté et de richesse
Les indices de richesse et de pauvreté ont été calculés sur l’ensemble des IRIS pour lesquels les déciles de revenus sont disponibles. A noter que des seuils de
diffusion
diffusion
Passage d'une émission ou d'un programme à la télévision ou à la radio. Ce terme fait référence à un programme "live" par opposition à la consultation à la demande.
En savoir plus
sont définis pour les indicateurs sur le revenu disponible à partir du nombre total de ménages ou de personnes dans la zone dont le revenu disponible est positif ou nul. Les déciles ne sont disponibles que pour les IRIS de plus 1 000 personnes fiscales et de plus de 500 ménages fiscaux dont le revenu disponible est positif ou nul.
Les IRIS pour lesquels les indices ont pu être calculés couvrent 75% de la
population
population
Univers d'une enquête composé des unités statistiques de base. Ces unités peuvent être des personnes physiques, des foyers, des entreprises, des communes... La population sert de base de sondage pour le choix de l'échantillon, et de base de calcul pour les extrapolations de l'échantillon.
En savoir plus
6 ans et plus. Dans le
panel
panel
Échantillon pour lequel le recueil de l'information s'inscrit dans le temps. Il peut être interrogé plusieurs fois à intervalles réguliers. Cette méthode est pertinente pour l'étude des évolutions de comportement.
L'échantillon peut être interrogé en continu :
- soit, il est demandé à chaque individu du panel de remplir un questionnaire journalier relatif au sujet de l'étude. C'est le cas du panel Radio.
- soit, l'information est enregistrée et restituée régulièrement. C'est le cas du panel Médiamat. Cette méthode est pertinente pour saisir les habitudes de comportement et leur évolution si la durée du panel est suffisamment longue.
En savoir plus
Médiamat
Médiamat
« Nom déposé, le Médiamat est la mesure automatique de référence de l’audience de la télévision en France. Réalisée par Médiamétrie, elle restitue quotidiennement l’audience des programmes regardés en tous lieux, sur tous les écrans et visionnés en live, différé, replay ou preview par l’ensemble des Français âgés de 4 ans et plus, soit 62,4 millions d’individus.
Cette mesure repose sur 2 panels représentatifs de la population :
- Un premier panel d’environ 12 000 individus répartis dans 5 500 foyers composé de :
• 5 000 foyers équipés de téléviseurs à domicile reliés chacun à un audimètre fixe, source de la mesure de l’audience TV à domicile
• 500 foyers sans téléviseur à domicile
- Un second panel d'environ 5 000 individus portant un audimètre miniature pour mesurer notamment les audiences TV hors domicile (tous écrans confondus) et sur les écrans internet à domicile. Ces audiences sont ensuite attribuées aux individus du premier panel par fusion statistique.
Le Médiamat permet un suivi quotidien des comportements du public, tout en offrant des possibilités d'analyses à la fois éditoriales et publicitaires. »
En savoir plus
, ils correspondent à 71,5% des individus 6 ans et plus et dans le panel AIP, ils correspondent à 75,9% des individus 15 ans et plus.
Les indices ont ensuite été triés pour déterminer les 10%, 5% et 1% les plus élevés. On compare ensuite la distribution théorique de ces tops avec celle observée dans le panel, sur la base des individus pour lesquels l’IRIS a été qualifié.
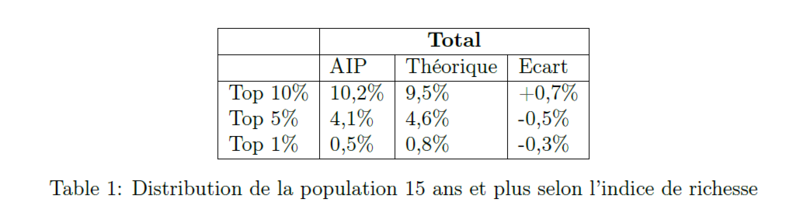
Grille de lecture : 10,2% des individus 15 ans et plus de l’AIP, résidant dans un IRIS qualifié selon l’indice de richesse, vivent dans un IRIS du top 10% les plus riches contre 9,5% de l’ensemble des individus 6 ans et plus en France ; soit un écart de +0,7 pts.
On observe dans le Tab.1 des écarts assez faibles entre le
panel
panel
Échantillon pour lequel le recueil de l'information s'inscrit dans le temps. Il peut être interrogé plusieurs fois à intervalles réguliers. Cette méthode est pertinente pour l'étude des évolutions de comportement.
L'échantillon peut être interrogé en continu :
- soit, il est demandé à chaque individu du panel de remplir un questionnaire journalier relatif au sujet de l'étude. C'est le cas du panel Radio.
- soit, l'information est enregistrée et restituée régulièrement. C'est le cas du panel Médiamat. Cette méthode est pertinente pour saisir les habitudes de comportement et leur évolution si la durée du panel est suffisamment longue.
En savoir plus
AIP et la structure théorique France entière, notamment sur le top 1% des IRIS les plus riches, ce qui démontre la bonne
dispersion
dispersion
En statistique, la dispersion est la variabilité des valeurs d'une série. Les indicateurs les plus courants de mesure de la dispersion d'une série de valeurs autour de la moyenne sont la variance et l'écart-type. En sondages, la dispersion géographique désigne la distribution de l'échantillon sur l'ensemble du territoire.
En savoir plus
géographique du panel et la présence de panélistes y compris dans les quartiers les plus aisés.
Ces résultats éclairent nos panels mais ont leur limites. Une limite est la granularité des données. Ne pouvant qualifier directement nos panélistes, nous travaillons au niveau de l’IRIS en faisant implicitement l’hypothèse qu’un panéliste résidant dans un IRIS est
représentatif
représentatif
Un échantillon est dit représentatif lorsqu'il provient d’un tirage représentatif, ce qui signifie que tous les individus de la population ont une probabilité non nulle d’être sélectionnés. La représentativité est une propriété d'un échantillon et non d'une unité de la population. Elle n’est pas synonyme d'échantillon proportionnel ou de "modèle réduit" de la population étudiée. On démontre en théorie des sondages, qu’une stratégie d’échantillonnage optimale consiste à organiser l’échantillon selon les variables les plus corrélées à l’objet de l’étude.
En savoir plus
de l’indicateur associé à cet IRIS. Notons par ailleurs que les 5826 individus âgés de 15 ans et plus du panel sont répartis dans 5135 IRIS distincts, soit 1.20 individus par IRIS, à la date d’étude.
3. Mesurer la diversité par l’entropie
En s’inspirant de la littérature sur la ségrégation scolaire[1, 2] ou encore l’application de sa théorie à la ségrégation résidentielle selon le niveau de vie[4], nous explorons l’entropie, en tant qu’indicateur de mesure de la diversité sociale.
3.1 Définition & cadre théorique
L’indice d’entropie que nous allons utiliser est lui-même tiré des travaux de Shanon sur la théories de l’information[4].
Définition 1. Soit P une mesure de probabilité probabilité La probabilité d'un événement est un nombre réel compris entre 0 et 1 reflétant la chance que cet événement a de se réaliser. Un événement impossible a une probabilité égale à 0 ; un événement certain a une probabilité égale à 1. La théorie et le calcul des probabilités sont à la base de la statistique mathématique et des sondages. En savoir plus . Dans le cas où P est défini sur {1, ..., n}, par P(i) = pi avec Σpi = 1, on obtient :
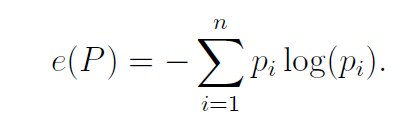
L’entropie mesure la diversité interne d’une distribution. Elle s’interprète relativement, une entropie élevée indique une
répartition
répartition
Terme utilisé dans le sens de distribution d'une variable ; on parle aussi de structure. En statistique, la fonction de répartition d'une variable quantitative donne pour chaque valeur x de cette variable la proportion d'individus pour lesquels la valeur de la variable est inférieure ou égale à x.
En savoir plus
homogène entre les classes, tandis qu’une entropie faible démontre une forte concentration.
Définition 2. Soit Z un
univers
univers
Ensemble des unités statistiques dans lequel est tiré l'échantillon d'une enquête. Lorsque ces unités sont des individus, on parle de population.
En savoir plus
d’étude divisé en K zones Zk. Les individus appartiennent à l’une des l classes de la caractéristique X donnée. Pour chaque zone Zk, la distribution de X dans les l modalités est la suivante : Pk = (p1k , ..., plk ).
P = (p1, ..., pl) est la distribution de X au sein des l modalités dans l’univers Z. πk est la proportion d’unités dans la zone Zk.
L’indice d’entropie est défini de la sorte :
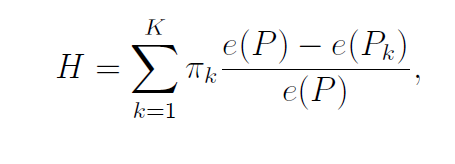
où :
• e(Pk) représente la diversité des modalités de X au sein de la zone Zk,
• e(P) représente la diversité des modalités de X dans l’univers Z.
H représente la somme des écarts relatifs entre la diversité au sein de chaque unité Zk par rapport à la zone globale Z.
Un indice d’entropie H faible indique une
répartition
répartition
Terme utilisé dans le sens de distribution d'une variable ; on parle aussi de structure. En statistique, la fonction de répartition d'une variable quantitative donne pour chaque valeur x de cette variable la proportion d'individus pour lesquels la valeur de la variable est inférieure ou égale à x.
En savoir plus
équilibrée, où chaque zone Zk reproduit la répartition globale. A contrario, un indice d’entropie élevé est caractéristique d’une forte hétérogénéité entre chaque zone Zk.
Pour analyser la diversité, il est important que l’indicateur choisi respecte certaines propriétés [2], notamment le principe de l’invariance à la composition ainsi que qu’à l’échelle. Le premier signifie que si un groupe social augmente dans la
population totale
population totale
Désigne la population des ménages ainsi que les communautés (foyers de travailleurs, maisons de retraite, résidences universitaires, maisons de détention…), les sans-abris, les mariniers et les personnes vivant dans des habitations mobiles.
En savoir plus
, et que ça se retranscrit dans les mêmes proportions dans chaque zone Zk alors la ségrégation demeure inchangée. Le second conclut que la ségrégation reste inchangée si le nombre total d’unités d’un zone Zk augmente, tant que sa répartition relative entre les zones n’est pas altérée.
3.2 Applications et perspectives
L’indice d’entropie H permet de comparer les niveaux de ségrégation ou de diversité entre zones géographiques. En reprenant le cadre théorique explicité ci-dessus:
– l’univers d’étude Z seront alternativement, le
panel
panel
Échantillon pour lequel le recueil de l'information s'inscrit dans le temps. Il peut être interrogé plusieurs fois à intervalles réguliers. Cette méthode est pertinente pour l'étude des évolutions de comportement.
L'échantillon peut être interrogé en continu :
- soit, il est demandé à chaque individu du panel de remplir un questionnaire journalier relatif au sujet de l'étude. C'est le cas du panel Radio.
- soit, l'information est enregistrée et restituée régulièrement. C'est le cas du panel Médiamat. Cette méthode est pertinente pour saisir les habitudes de comportement et leur évolution si la durée du panel est suffisamment longue.
En savoir plus
Médiamat
Médiamat
« Nom déposé, le Médiamat est la mesure automatique de référence de l’audience de la télévision en France. Réalisée par Médiamétrie, elle restitue quotidiennement l’audience des programmes regardés en tous lieux, sur tous les écrans et visionnés en live, différé, replay ou preview par l’ensemble des Français âgés de 4 ans et plus, soit 62,4 millions d’individus.
Cette mesure repose sur 2 panels représentatifs de la population :
- Un premier panel d’environ 12 000 individus répartis dans 5 500 foyers composé de :
• 5 000 foyers équipés de téléviseurs à domicile reliés chacun à un audimètre fixe, source de la mesure de l’audience TV à domicile
• 500 foyers sans téléviseur à domicile
- Un second panel d'environ 5 000 individus portant un audimètre miniature pour mesurer notamment les audiences TV hors domicile (tous écrans confondus) et sur les écrans internet à domicile. Ces audiences sont ensuite attribuées aux individus du premier panel par fusion statistique.
Le Médiamat permet un suivi quotidien des comportements du public, tout en offrant des possibilités d'analyses à la fois éditoriales et publicitaires. »
En savoir plus
, le panel AIP ou encore la France entière,
– l’univers d’étude Z sera divisé en K départements, où Zk est un département k donné,
– pi correspondra aux distributions des classes de variables socio-démographiques.
Les résultats de cette analyse ont été présentés lors du 14ème colloque francophone sur les sondages (2026).
Références
[1] Gabrielle Fack, Julien Grenet, and Asma Benhenda. “L’impact des procédures de sectorisation et d’affectation sur la mixité sociale et scolaire dans les lycées d’Île-de-France”. PhD thesis. Institut des politiques publiques (IPP), 2014.
[2] Pauline Givord et al. “Comment mesurer la ségrégation dans le système éducatif?” In: Éducation & formations 91 (2016), pp. 21–51.
[3] Argyro Gripsiou and Christophe Bergouignan. “La polarisation socio-économique interne des quartiers centraux des métropoles françaises de province”. In: Espace populations sociétés. Space populations societies 2022/2-3 (2022).
[4] Salomon Jean-Bernard. “Décomposition de l’indice d’entropie normalisée pour l’étude de la ségrégation”. In: Journées de méthodologie
statistique
statistique
La statistique ou science des données (Data Science en anglais) est un domaine des mathématiques qui étudie des phénomènes à travers la collecte de données, leur traitement, leur analyse, leur représentation graphique ou visualisation (Data Visualization en anglais) et l'interprétation des résultats.
En savoir plus
de l’Insee (2025).
[5] et al Pornet Carole. “Construction of an adaptable European transnational ecological deprivation index: the French version”. In: J Epidemiol Community Health (66 2012), pp. 982–989.
[6] Fouillet A. et al Rey G. Jougla E. “Ecological association between a deprivation index and mortality in France over the period 1997 – 2001: variations with spatial scale, degree of urbanicity, age, gender and cause of death.” In: BMC Public Health (33 2012).
Résumé
La diversité sociale des panels est un enjeu central pour la représentativité des mesures d’audience, dans un contexte où la collecte de
données sensibles
données sensibles
Les données sensibles forment une catégorie particulière des données personnelles.
Ce sont des informations qui révèlent la prétendue origine raciale ou ethnique, les opinions politiques, les convictions religieuses ou philosophiques ou l'appartenance syndicale, ainsi que le traitement des données génétiques, des données biométriques aux fins d'identifier une personne physique de manière unique, des données concernant la santé ou des données concernant la vie sexuelle ou l'orientation sexuelle d'une personne physique.
Le règlement européen interdit de recueillir ou d’utiliser ces données, sauf, notamment, dans les cas suivants :
si la personne concernée a donné son consentement exprès (démarche active, explicite et de préférence écrite, qui doit être libre, spécifique, et informée) ;
si les informations sont manifestement rendues publiques par la personne concernée ;
si elles sont nécessaires à la sauvegarde de la vie humaine ;
si leur utilisation est justifiée par l'intérêt public et autorisé par la CNIL ;
si elles concernent les membres ou adhérents d'une association ou d'une organisation politique, religieuse, philosophique, politique ou syndicale.
En savoir plus
est fortement encadrée. Cet article propose une approche indirecte de la mesure de la diversité sociale des panels de Médiamétrie, fondée sur l’exploitation d’indices socio-économiques territoriaux calculés à l’échelle infracommunale (IRIS). Deux indices de défavorisation — le French Deprivation Index (FDep) et l’European Deprivation Index (EDI) — ainsi que des indices de pauvreté et de richesse basés sur les déciles de revenus sont mobilisés pour qualifier les panels.
Les distributions observées sont comparées à celles de la
population
population
Univers d'une enquête composé des unités statistiques de base. Ces unités peuvent être des personnes physiques, des foyers, des entreprises, des communes... La population sert de base de sondage pour le choix de l'échantillon, et de base de calcul pour les extrapolations de l'échantillon.
En savoir plus
française afin d’identifier d’éventuelles distorsions de représentativité. Enfin, l’article explore l’entropie comme indicateur synthétique de diversité sociale, permettant de dépasser les comparaisons marginales et d’analyser la
dispersion
dispersion
En statistique, la dispersion est la variabilité des valeurs d'une série. Les indicateurs les plus courants de mesure de la dispersion d'une série de valeurs autour de la moyenne sont la variance et l'écart-type. En sondages, la dispersion géographique désigne la distribution de l'échantillon sur l'ensemble du territoire.
En savoir plus
interne des panels de manière globale. Cette approche ouvre des perspectives méthodologiques pour un pilotage plus fin de la diversité.