Fusion de données : définition, méthodes et enjeux pour les études et la mesure d’audience
La fusion de données permet de combiner plusieurs sources d’information issues d’enquêtes distinctes pour reconstituer une vision plus complète d’une même population. Cette méthode est largement utilisée dans les études et la mesure d’audience lorsqu’il devient difficile de collecter toutes les informations souhaitées auprès des mêmes personnes. Elle répond à un double enjeu : préserver la qualité de la collecte tout en produisant des résultats riches et exploitables.
Pourquoi recourir à la fusion de données ?
Dans un contexte de baisse de la joignabilité et des taux de réponse aux enquêtes, la collecte de l’information est devenue un enjeu majeur. Pour limiter le fardeau de réponse*, les sociétés d’études doivent concevoir des questionnaires plus courts, plus simples et mieux adaptés aux conditions réelles de collecte.
Ainsi, plutôt que de recueillir l’ensemble des informations souhaitées auprès d’un unique échantillon, on peut choisir de collecter une partie des variables d’intérêt auprès d’un premier échantillon et l’autre partie auprès d’un second échantillon, disjoint du premier. L’enjeu est alors de combiner ces sources d’information multiples de manière à obtenir une information complète.
C'est précisément le problème auquel répond la fusion statistique fusion statistique La fusion statistique est une méthode utilisée afin de rapprocher des données provenant d'enquêtes différentes. Elle consiste à compléter un échantillon dit "receveur", où certaines informations ne sont pas présentes, à l'aide d'un échantillon dit "donneur" portant sur d'autres individus. Pour cela, les deux échantillons doivent disposer d'informations communes, appelées variables de pont. La fusion statistique est un cas particulier du traitement de la non-réponse. En savoir plus de données (statistical matching ou data data les données numériques En savoir plus fusion en anglais) : combiner deux sources indépendantes, portant sur la même population population Univers d'une enquête composé des unités statistiques de base. Ces unités peuvent être des personnes physiques, des foyers, des entreprises, des communes... La population sert de base de sondage pour le choix de l'échantillon, et de base de calcul pour les extrapolations de l'échantillon. En savoir plus mais collectant des informations différentes, pour créer une base de données unique et complète.
*Le fardeau de réponse (response burden en anglais) désigne la charge (temps, effort de mémoire, complexité…) imposée aux répondants à une enquête enquête Dispositif de recueil d'informations. On distingue les enquêtes téléphoniques, postales, en face-à-face, en ligne. Bien qu'ayant un sens plus large, le terme d'étude est souvent utilisé comme synonyme. En savoir plus . C’est un concept central en méthodologie d’enquête car il influence directement la qualité de la participation et la fiabilité des réponses.
Origine et développement de la fusion de données
Les premières expérimentations apparaissent au milieu des années 1960, de manière indépendante en Allemagne, en France et au Royaume-Uni. Elles sont portées par des instituts privés qui cherchent à croiser les audiences de différents médias — presse, radio, télévision. Le nombre de supports ne cessant de croître, le modèle d'une enquête enquête Dispositif de recueil d'informations. On distingue les enquêtes téléphoniques, postales, en face-à-face, en ligne. Bien qu'ayant un sens plus large, le terme d'étude est souvent utilisé comme synonyme. En savoir plus unique couvrant l’ensemble des médias (single source) atteint ses limites, à la fois en coût et en fardeau de réponse pour les personnes interrogées.
Aux États-Unis et au Canada, ce sont les instituts de statistique statistique La statistique ou science des données (Data Science en anglais) est un domaine des mathématiques qui étudie des phénomènes à travers la collecte de données, leur traitement, leur analyse, leur représentation graphique ou visualisation (Data Visualization en anglais) et l'interprétation des résultats. En savoir plus publique qui portent la recherche, notamment pour fusionner des fichiers administratifs dont le croisement exact est interdit par la réglementation sur la protection de la vie privée (Privacy Act de 1974). Statistique Canada contribue de manière intensive dans les années 1990 à l'amélioration de ces techniques, en particulier sur la question question Interrogation posée à l'identique à toutes les personnes participant à une même enquête, dans le but d'obtenir des réponses de même nature. On distingue les questions fermées, dont les réponses sont à choisir parmi les modalités proposées (échelles, oui ou non, modalités d'une nomenclature, etc...), des questions ouvertes, pour lesquelles aucune modalité de réponse n'est proposée. Dans ce dernier cas, c'est la réponse spontanée des personnes interrogées qui est recueillie. En savoir plus de l'hypothèse d'indépendance conditionnelle.
L'usage de la fusion s'est ensuite largement répandu dans les années 1980-1990 dans le domaine domaine La mesure d'audience Internet de Médiamétrie propose une nomenclature technique. Cette nomenclature se divise en 3 niveaux : pages, sous domaines et domaines Le domaine est le niveau le plus haut : domaine.com Le sous domaine est un sous ensemble du domaine. Les sous domaines de domaine.com sont toutes les URLs en quelquechose.domaine.com Les pages sont un sous ensemble du niveau sous domaine. Elles sont au format : quelquechose.domaine.com/quelquechose En savoir plus des études de marché et d'audience média, car il offre une réponse à la fois économique — un recueil complet serait coûteux — et pragmatique — le fichier fusionné est directement exploitable dans les logiciels standard.
Quel est le principe général de la fusion de données ?
Le principe est simple. On dispose de deux échantillons A et B, tirés de la même population population Univers d'une enquête composé des unités statistiques de base. Ces unités peuvent être des personnes physiques, des foyers, des entreprises, des communes... La population sert de base de sondage pour le choix de l'échantillon, et de base de calcul pour les extrapolations de l'échantillon. En savoir plus :
- L'échantillon A contient des variables X (sociodémographiques, par exemple) et des variables Y ;
- L'échantillon B contient les mêmes variables X et des variables Z.
Y et Z ne sont jamais observées conjointement. L'objectif est de créer un fichier C dans lequel chaque individu possède à la fois X, Y et Z.
Pour cela, on désigne un fichier « receveur » (A) et un fichier « donneur » (B). Pour chaque individu i du fichier receveur, on recherche dans le fichier donneur un « sosie » j, c'est-à-dire un individu qui lui ressemble le plus au regard des variables communes X. Les valeurs de Z du sosie sont alors imputées au receveur.
L'indépendance conditionnelle : l'hypothèse clé de la fusion de données
Toute fusion repose sur une hypothèse forte : sachant X, les variables Y et Z sont indépendantes. Autrement dit, on suppose que la relation entre Y et Z est entièrement expliquée par leur relation respective à X. Cette hypothèse ne peut pas être vérifiée directement puisque Y et Z ne sont jamais observées ensemble. C'est pourquoi le pouvoir explicatif des variables communes X sur Y et Z est déterminant pour la qualité de la fusion.
Quelles sont les grandes étapes d'une fusion de données ?
Le processus de fusion comporte généralement quatre étapes :
Étape 1 — sélectionner les variables communes les plus explicatives
Toutes les variables X n'ont pas le même pouvoir prédictif sur Y et Z. Inclure des variables non significatives peut même dégrader la fusion. On utilise donc des algorithmes de sélection classiques pour ne retenir que les variables communes les plus pertinentes.
Étape 2 — stratifier les échantillons pour garantir la comparabilité
On impose une parfaite similitude entre donneurs et receveurs sur un sous-ensemble de variables clés (sexe, tranche d'âge…). On définit ainsi K strates strates Une stratification est un découpage d'une population ou d'un échantillon, en groupes les plus homogènes possibles. Ces groupes sont appelés strates. En savoir plus au sein desquelles les fusions sont réalisées séparément. Cela garantit, par exemple, qu'une femme de 15-24 ans ne sera jamais appariée à un homme de 50 ans. La stratification permet aussi de réduire les temps de calcul.
Étape 3 — Calculer la matrice de distance
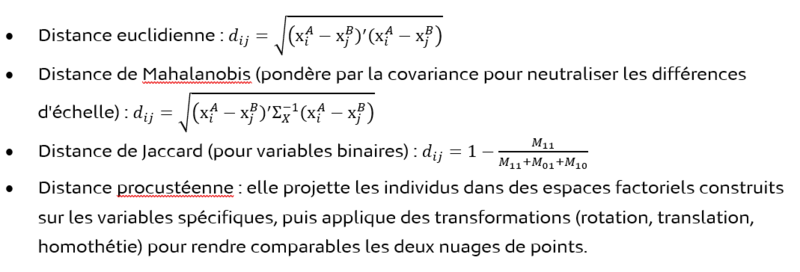
Au sein de chaque strate, on quantifie la ressemblance entre chaque receveur i et chaque donneur j. Parmi les fonctions de distance les plus utilisées, on trouve :
Étape 4 — Choisir une méthode de jumelage adaptée
Il existe de nombreux algorithmes de jumelage parmi lesquels :
- Plus proche voisin : chaque receveur i reçoit le donneur j le plus proche. Il s’agit d’une méthode très simple à mettre en œuvre et qui permet de minimiser la distance totale mais la contrepartie est un risque de réplication importante de certains donneurs et la difficulté de préserver les distributions marginales des variables Z.
- Appariement avec contrainte de non-réplication : on minimise la distance totale sous la contrainte que chaque donneur ne soit utilisé qu'une seule fois. Il s'agit d'un problème classique d'optimisation : le problème du voyageur de commerce. Il existe de nombreux algorithmes de résolution de ce problème. L’avantage de cette méthode est qu’elle permet une meilleure préservation des distributions marginales des variables Z mais au détriment de la distance totale et des temps de calcul.
- Appariement sous contrainte de conservation des poids poids 1. Proportion d'une catégorie d'individus par rapport à la totalité de la population. Par exemple, au 1er janvier 2020, le poids des femmes est de 51,7% de la population des ménages. 2. Le poids de sondage désigne le coefficient affecté à chaque individu de l'échantillon et qui représente l'inverse de sa probabilité d'appartenir à l'échantillon. Par exemple, pour un échantillon de 20 000 individus tirés aléatoirement au sein d'une population de 40 millions d'individus, le poids de sondage est de 2 000. 3. Le poids de redressement désigne le coefficient affecté à chaque individu après redressement de l'échantillon et qui correspond au nombre d'individus que cet individu de l'échantilllon représente dans la population. En savoir plus : on minimise la distance totale sous la contrainte que les poids de sondage sondage Méthode statistique qui vise à produire des informations sur une population en n’interrogeant qu’une partie de celle-ci (échantillon). Ce mot est généralement utilisé pour désigner une enquête menée auprès d'un échantillon, interrogé par questionnaire ou observé de façon systématique. En savoir plus de chaque unité soient intégralement redistribués. Ce problème de transport est un autre problème classique d’optimisation linéaire linéaire Désigne le fait de regarder un programme de télévision en live, en timeshifting (contrôle du direct) ou en différé privé (avec un enregistrement personnel). En savoir plus . On peut démontrer que la solution optimale donne lieu à nA + nB -1 jumelages.
Avantages, limites et points de vigilance de la fusion de données
La fusion de données constitue une solution pragmatique efficace, en évitant un recueil exhaustif coûteux sur un même échantillon. Elle réduit également le fardeau de réponse grâce à des questionnaires plus courts, ce qui améliore à la fois les taux de participation et la qualité des données. Le résultat est un fichier complet, directement exploitable dans des formats standards compatibles avec les outils d’analyse classiques. Enfin, elle permet de produire des mesures cross-média à partir de dispositifs existants sans recourir à un
panel
panel
Échantillon pour lequel le recueil de l'information s'inscrit dans le temps. Il peut être interrogé plusieurs fois à intervalles réguliers. Cette méthode est pertinente pour l'étude des évolutions de comportement.
L'échantillon peut être interrogé en continu :
- soit, il est demandé à chaque individu du panel de remplir un questionnaire journalier relatif au sujet de l'étude. C'est le cas du panel Radio.
- soit, l'information est enregistrée et restituée régulièrement. C'est le cas du panel Médiamat. Cette méthode est pertinente pour saisir les habitudes de comportement et leur évolution si la durée du panel est suffisamment longue.
En savoir plus
unique complexe.
En revanche, la fusion de données repose sur des hypothèses fortes, notamment celle de l’indépendance conditionnelle : si les variables communes n’expliquent pas suffisamment les variables spécifiques, le modèle aura du mal à reconstituer les relations entre les variables, les duplications par exemple. De plus, le fichier fusionné résulte d'une modélisation et non d'une observation directe. La précision des résultats ne peut donc s’apprécier par un calcul de marges d’erreur classique. La mise en œuvre d’une fusion nécessite donc une étape de validation rigoureuse pour garantir la fiabilité des résultats;